استكشاف محولات الرؤية ذاتية الإشراف للتعرف على المشية في البرية الجزء 2
Nov 24, 2023
2.2. محولات الرؤية
في حين تم اقتراحها في البداية لمهام البرمجة اللغوية العصبية [16،34] بنجاح هائل، أصبحت المحولات تستخدم على نطاق واسع في رؤية الكمبيوتر في السنوات الأخيرة [24،25،28،35–37). يتمتع كلا المجالين بأداء غير مسبوق باستخدام أشكال مختلفة من المحولات، ويرجع ذلك جزئيًا إلى زيادة سعة النموذج وقدرة المحولات على الاستفادة من الإشراف الذاتي أكثر بكثير من النماذج السابقة [17].
ترتبط المراقبة الذاتية والذاكرة ارتباطًا وثيقًا. تشير المراقبة الذاتية إلى تقييم وتعديل سلوك الفرد وتفكيره وعواطفه، بينما تشير الذاكرة إلى القدرة على اكتساب المعلومات ومعالجتها وتخزينها. يمكن أن تساعدنا المراقبة الذاتية على التحكم بشكل أفضل في سلوكنا وعواطفنا، وبالتالي تحسين الذاكرة.
أولاً، يمكن للمراقبة الذاتية أن تساعدنا على مقاومة الإغراءات بشكل أفضل. يميل الإغراء إلى صرف انتباهنا وطاقتنا والتأثير على ذاكرتنا. ومن خلال المراقبة الذاتية، يمكننا التحكم في أنفسنا بشكل أفضل وتجنب التشتيت المفرط، وبالتالي تعزيز الذاكرة.
ثانيًا، يمكن أن تساعدنا المراقبة الذاتية أيضًا على فهم المعلومات وتذكرها بشكل أفضل. تسمح لنا المراقبة الذاتية بإيلاء المزيد من الاهتمام للنقاط الرئيسية للمعلومات والاهتمام بالروابط بين المعلومات لفهم المعلومات وتذكرها بشكل أفضل. عندما ننتبه، نكون مجهزين بشكل أفضل لفهم المعلومات والاحتفاظ بها.
وأخيرًا، يمكن أن تساعدنا المراقبة الذاتية أيضًا على مراقبة سلوكنا وتفكيرنا وتلخيصها بشكل أفضل. ومن خلال التفكير في أفعالنا وعمليات تفكيرنا، يمكننا تحديد أوجه القصور وتحسينها. ولا يؤدي هذا التحسن إلى تحسين سلوكنا وتفكيرنا فحسب، بل يعزز أيضًا قدرات ذاكرتنا.
باختصار، ترتبط المراقبة الذاتية والذاكرة ارتباطًا وثيقًا. من خلال المراقبة الذاتية، يمكننا التحكم في أنفسنا بشكل أفضل، وفهم المعلومات وتذكرها بشكل أفضل، وتحسين سلوكنا وعمليات تفكيرنا بشكل أفضل. وفي الوقت نفسه، سيساعدنا هذا أيضًا على تحسين ذاكرتنا، مما يسمح لنا بالدراسة والعمل بكفاءة أكبر. دعونا نوضح أهدافنا، ونعدل أنفسنا بنشاط، ونتابع التقدم باستمرار! يمكن ملاحظة أننا بحاجة إلى تحسين الذاكرة، ويمكن لـ Cistanche deserticola أن يحسن الذاكرة بشكل كبير، لأن Cistanche deserticola يمكنه أيضًا تنظيم توازن الناقلات العصبية، مثل زيادة مستويات الأسيتيل كولين وعوامل النمو. هذه المواد مهمة جدًا للذاكرة والتعلم. بالإضافة إلى ذلك، يمكن للحوم أيضًا تحسين تدفق الدم وتعزيز توصيل الأكسجين، مما يضمن حصول الدماغ على ما يكفي من العناصر الغذائية والطاقة، وبالتالي تحسين حيوية الدماغ والقدرة على التحمل.

انقر فوق معرفة المكملات الغذائية لتحسين الذاكرة
دوسوفيتسكي وآخرون. [24] كانوا أول من اقترح استخدام برامج تشفير المحولات لتصنيف الصور، حيث قدم محول الرؤية (ViT). تقسم البنية الصورة المدخلة إلى تصحيحات ذات حجم ثابت مقاس 16 × 16، وتسطحها، وتعرضها بطبقة خطية إلى بُعد التضمين. يتم إدراج رمز مميز للفئة الإضافية (CLS) في التسلسل وتتم إضافة الترميزات الموضعية إلى كل متجه.
يتم إعطاء التسلسل الناتج من التضمين كمدخل لمشفر المحول، والذي له نفس البنية الموجودة في [34] ولكنه يستخدم عامل LayerNorm قبل كل كتلة بدلاً من بعد (المعيار المسبق). يتم استخدام MLPhead للحصول على تسمية الفئة من المعلومات المجمعة عالميًا في رمز الفئة.
آلية الاهتمام الذاتي التي قدمها فاسواني وآخرون. [34] يأخذ تسلسلًا من العناصر كمدخل ويقدر التفاعل بينها جميعًا من خلال تجميع المعلومات العالمية لكل عنصر في التسلسل. لحساب التفاعلات المختلفة بين عناصر التسلسل، تقوم وحدة الانتباه الذاتي متعدد الرؤوس (MSA) بتسلسل نتائج كتل الاهتمام الذاتي المتعددة وتسقط المخرجات على مصفوفة وزن قابلة للتعلم. يتكون مشفر المحول المقدم في [34] من طبقات مكدسة متعددة تتكون من كتلة MSA وكتلة تغذية للأمام (FFN) واتصالات متبقية بين كل كتلة وLayerNorm (LN) بعد كل كتلة.
توفرون وآخرون. [25] يقترح تغييرين معماريين لتحسين أداء محولات الرؤية العميقة. مساهمتهم الأولى، LayerScale، تسهل تدريب النماذج الأعمق عن طريق إضافة مصفوفة قطرية قابلة للتعلم والتي يتم ضربها بمخرجات الكتل المتبقية. نظرًا لأن المصفوفة تمت تهيئتها بقيم صغيرة، فإنها تجبر نتائج طبقات تشفير المحولات على أن يكون لها مساهمة صغيرة في إخراج الكتلة المتبقية في بداية التدريب.
مساهمتهم الثانية هي آلية الاهتمام الطبقي. بدلاً من إلحاق رمز CLS المميز في البداية، كما هو الحال في ViT القياسي، يتم إلحاقه بعد عدة كتل تشفير. بعد هذه المرحلة، يتم تحديث رمز الفئة فقط ويتم الاحتفاظ برموز التصحيح مجمدة. تساعد هذه الآلية في فصل عمليات الاهتمام الذاتي بين التصحيحات عن تجميع المعلومات التي سيتم استخدامها للتصنيف.
يوان وآخرون. [28] يجادل بأن الترميز البسيط للبقع في Vanilla ViT له حدود لعدم القدرة على نمذجة البنية المحلية للصورة والتفاعل بين البقع المجاورة. وبالتالي، يقدمون عملية ترميز تقدمية تجمع بين الرموز المميزة المجاورة في رمز واحد.
تتكون هذه العملية من وحدة إعادة التشكيل، التي تأخذ تسلسل الرموز المميزة من الطبقة السابقة وتبني صورة منها بناءً على القرب المكاني. تقوم وحدة Soft Split بتقسيم الصورة التي تم إنشاؤها إلى بقع متداخلة من الرموز المميزة وتغذيها إلى برنامج التشفير التالي. يتم إدخال الرموز المميزة التي تم إنشاؤها بعد عملية الترميز في العمود الفقري الضيق العميق للتصنيف.
كما لاحظ وانغ وآخرون. [35] تم تصميم Vision Transformer القياسي خصيصًا لتصنيف الصور وهو غير مناسب لمهام أخرى مثل اكتشاف الكائنات أو تجزئةها. ولهذا السبب، يقترحون محول الرؤية الهرمية (PVT) الذي يستلهم تصميمات CNN من خلال إنتاج خرائط ميزات وسيطة ذات أبعاد مكانية متناقصة وعدد متزايد من القنوات.
يساعد هذا الهيكل الهرمي النموذج في تعلم ميزات متعددة النطاق يمكن استخدامها لمهام مختلفة. يقوم النموذج أولاً بمعالجة الرموز المميزة التي تم الحصول عليها من بقع ذات أبعاد 4 × 4، وفي كل مرحلة، تتوافق الرموز المميزة مع أبعاد مكانية أكبر للبقع.
التكلفة الحسابية للانتباه الذاتي الكلاسيكي هي O(N2·d) حيث N هو عدد الرموز المميزة في التسلسل وd هو البعد المتجه. تصبح التكلفة الحسابية التربيعية من حيث عدد الرموز المميزة مشكلة عملية مع زيادة دقة صورة الإدخال نظرًا لأن كل رمز مميز في التسلسل يتوافق مع تصحيح في الصورة.
في الأدبيات، هناك العديد من التقنيات التي يمكن من خلالها تقليل التكلفة الحسابية للانتباه الذاتي بالفانيليا [26،35،36]. يستخدم PVT [35] اهتمام التخفيض المكاني، مما يقلل من الحجم المكاني لمتجهات المفتاح والقيمة قبل الاهتمام الذاتي من خلال عملية إعادة التشكيل والإسقاط الخطي.
محول Swin [36] الذي يحتوي أيضًا على هيكل هرمي يستبدل كتلة الانتباه الذاتي بوحدة تقريبية. تقوم الوحدة بتجميع التصحيحات المجاورة في النوافذ المحلية وتنفذ عملية الاهتمام الذاتي فقط داخل هذه النوافذ.
لتوصيل المعلومات مع النوافذ الأخرى، يقوم بتغيير النوافذ المحلية بحيث تحتوي أيضًا على تصحيحات من النوافذ المجاورة ويحسب الاهتمام الذاتي مرة أخرى. تشو وآخرون. [27] اعتمد بنية PVT واقترح طريقة مماثلة لتقريب الاهتمام الذاتي. كما قاموا أيضًا بإجراء اهتمام محلي بين التصحيحات الموجودة في النافذة، على غرار محول Swin.
ولإيصال المعلومات مع النوافذ الأخرى، قاموا بإجراء الانتباه الذاتي بين ممثل كل نافذة وجميع النوافذ الأخرى. يعتمد CrossFormer [26] أيضًا على PVT. إنه يستخدم الانتباه من مسافة قصيرة، والذي يشبه الانتباه المحلي في محول Swin، ولكن لتسريب المعلومات إلى النوافذ الأخرى فإنه يستخدم الانتباه من مسافة طويلة، والذي يحسب التفاعل بين التصحيحات، التي لها مسافة ثابتة بينها. كما أنه يجمع أيضًا بين التصحيحات متعددة المقاييس المتمركزة حول نفس البكسل للحصول على الرموز المميزة لكتل المحولات، مما يساعد النموذج في تعلم التفاعلات عبر المقاييس.
يانغ وآخرون. [37] يقترح آلية الاهتمام البؤري لتعلم التفاعلات القصيرة والطويلة المدى بين الرموز المميزة مما يجعل محولات الرؤية قادرة على معالجة الصور عالية الدقة. بالنسبة لكل تصحيح صورة، تقوم وحدة الاهتمام الذاتي البؤري بحساب التفاعلات مع التصحيحات المغلقة مكانيًا ومع النوافذ الملخصة للتصحيحات الأكثر بعدًا. يتم تلخيص نوافذ التصحيحات من خلال التجميع ولا يتم التقاط المعلومات عندما تكون التصحيحات بعيدة.
يستخدم RegionViT [38] بنية PVTarchitecture ويضيف مسارين للترميز لكل خريطة ميزات. يحصل مسار الترميز الأول على الرموز المميزة الإقليمية التي تتكون من تصحيحات تغطي عددًا كبيرًا من وحدات البكسل. ويحصل مسار الترميز الثاني على الرموز المميزة المحلية التي تلتقط معلومات منخفضة المستوى من خلال احتوائها على عدد قليل من وحدات البكسل. يتم تغذية هذين النوعين من الرموز كمدخلات لمشفر المحول الإقليمي إلى المحلي حيث يتم حساب الاهتمام الذاتي الأول بين المناطق، ثم بين كل رمز إقليمي والرموز المحلية المقابلة له.
تجمع بنية LeViT [39] بين كل من شبكات CNN وآلية الاهتمام الذاتي. يتم تغذية الصورة أولاً في مشفر CNN، مما يقلل الأبعاد المكانية ويزيد من أبعاد القناة. يتم تغذية خرائط الميزات الناتجة في ViT هرمي يحتوي على وحدة انتباه متقلصة بين أجهزة التشفير الخاصة بها لزيادة تقليل الأبعاد المكانية وزيادة بُعد القناة لخرائط الميزات.
كما تم استخدام البنى المبنية على الاهتمام في المهام المعتمدة على الفيديو حيث يجب أخذ المعلومات الزمنية بعين الاعتبار. تستخدم البنى المعمارية، مثل ViViT [40] وTimeSformer [41]، آلية الاهتمام الذاتي على كلا البعدين المكاني والزماني. ولهذا السبب، يتعلم النموذج التقاط المعلومات المكانية من كل إطار والتغيير بمرور الوقت.
3. الطريقة
في هذا القسم، نقدم وصفًا تفصيليًا لكل بنية ومعلمات فرطية مختارة. علاوة على ذلك، قمنا بوصف معالجة البيانات وقرارات التصميم المقترحة لتكييف محولات الرؤية للعمل مع التسلسل الهيكلي. وأخيرًا، قمنا بوصف طرق التهيئة وبروتوكول التقييم ومجموعات بيانات التقييم.
3.1. وصف العمارة
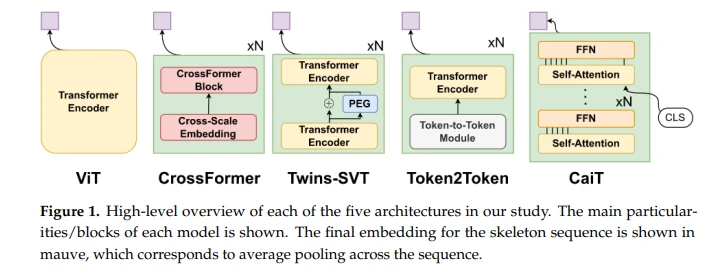
لقد استكشفنا خمسة أنواع مختلفة من محولات الرؤية (الشكل 1)، والتي تم تطويرها لإجراء عمليات حسابية أكثر تحسينًا على الصور، من حيث الأداء النهائي ووقت الاستدلال. على وجه الخصوص، نستكشف ViT الكلاسيكي [24]، وCaiT [25]، وToken2Token ViT [28]، وTwins-SVT [27].
بشكل عام، تتعامل النكهات الخاصة بمحولات الرؤية مع تحسينات على الطريقة "الكلاسيكية" لمعالجة الصور باستخدام المحولات، كما هو مقترح في ViT: يتم تقسيم الصور إلى بقع متساوية الحجم وغير متداخلة يتم تسويتها وإسقاطها في مساحة ذات أبعاد أقل ل سيتم التعامل معها بعد ذلك على أنها "رموز"، بطريقة مشابهة لتطبيقات البرمجة اللغوية العصبية. في حالة تحليل المشية، تتوافق الرقعة المربعة مع مجموعة من المفاصل التي تختلف عبر نافذة زمنية صغيرة.
يأخذ مشفر المحول القياسي سلسلة من العناصر كمدخل (X ∈ Rn×d حيث - عدد العناصر، d - بُعد التضمين) ويعرضها على ثلاث مصفوفات مختلفة للوزن قابلة للتعلم للحصول على الاستعلامات (Q ∈ Rn×dq)، والمفاتيح (K ∈ Rn×dk, dk=dq)، والقيم (V ∈ Rn×dv )، حيث dq وdk وdv هي أبعاد الاستعلامات والمفاتيح والقيم، على التوالي. يتم حساب الاهتمام على النحو التالي:
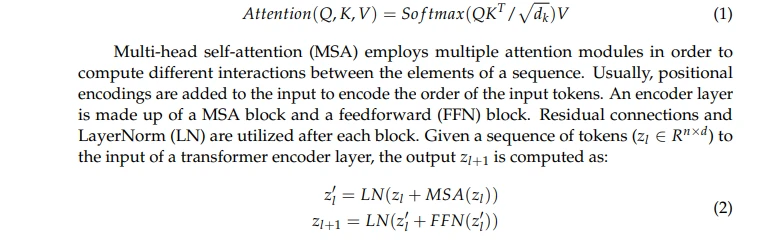
بالنسبة لمعظم البنيات، قمنا بإصلاح عدد الطبقات ورؤوس الانتباه وأبعاد الميزات كلما أمكن ذلك. على هذا النحو، نختار 4 طبقات مع 4 رؤوس انتباه لكل منها، وبُعد 512 لشبكة التغذية الأمامية، وحجم التضمين النهائي 128.

ViT يحصل محول الرؤية [24] على تسلسل إدخال من الرموز المميزة عن طريق تقسيم الصورة إلى تصحيحات وإسقاطها خطيًا على بُعد التضمين. يتم إعطاء التسلسل الناتج بالإضافة إلى رمز الفئة الإضافية (CLS) كمدخل لمشفر المحولات. علاوة على ذلك، يستخدم مشفر ViT معيارًا مسبقًا، بدلاً من ما بعد التطبيع. يمكن حساب مخرجات الطبقة على النحو التالي:
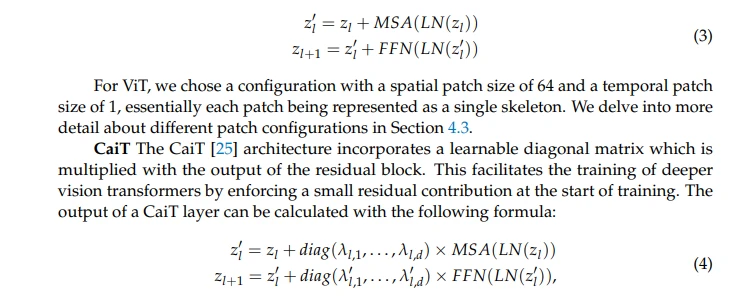
حيث Φl وi و lect0l، هي معلمات قابلة للتعلم. يقوم النموذج أيضًا بفصل حساب التفاعلات بين رموز الإدخال عن حساب تضمين الفئة التي تجمع كل المعلومات العالمية. يتم ذلك من خلال انتباه الفصل الذي يقدم رمز CLS المميز إلى تسلسل الإدخال بعد الحصول على التفاعلات وتجميد جميع الرموز المميزة الأخرى. بالنسبة لمشفر CaiT، استخدمنا نفس التكوين كما في ViT، ولكن بالنسبة لمشفر CLS، استخدمنا عمق طبقتين.
Token2Token ViT تحتوي بنية Token2Token [28] على عملية ترميز تقدمية تعمل على تصميم البنية المحلية للصورة من خلال الجمع بين الرموز المميزة المجاورة. تقوم عملية الترميز أولاً ببناء بنية تشبه الصورة من تسلسل إدخال من الرموز المميزة بمساعدة وحدة إعادة التشكيل. ثم يتم تقسيم الصورة إلى بقع متداخلة من الرموز عبر وحدة Soft Split (SS). يتم حساب الإخراج الناتج من tokenizationmodule على النحو التالي:
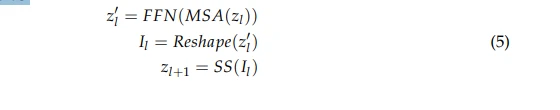
بالنسبة إلى Token2Token، استخدمنا طبقتين بأحجام التصحيح {2، 8} و{2، 4} للطبقة الأولى، و{4، 16} للطبقة الثانية.
Twins-SVT تستبدل بنية Twins-SVT [27] كتلة الاهتمام الذاتي الكلاسيكية بوحدة تسمى الاهتمام الذاتي القابل للفصل المكاني (SA) الذي تقريبي العملية. يتكون SSSA من الاهتمام الذاتي المجمع محليًا (LSA) الذي يحسب التفاعل فقط بين الرموز المميزة داخل نفس النافذة المحلية والاهتمام العالمي بالعينات الفرعية (GSA) الذي يجمع المعلومات العالمية عن طريق الاهتمام الذاتي بين جميع ممثلي كل نافذة محلية محسوبة عن طريق ربط الرموز المميزة المجاورة. يمكن كتابة عمليات طبقة aTwins على النحو التالي:
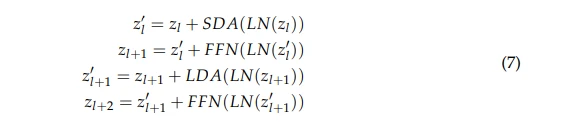
بالنسبة لمشفر CrossFormer، استخدمنا أبعاد {16، 32، 64، 128} للطبقات، وأحجام النوافذ العالمية {4، 2، 2، 1}، وحجم النافذة المحلية 2، وخطوات التضمين المتقاطع 2، والتقاطع - تضمين أحجام النواة {{2، 4، 8، 16}، {2، 4}، {2، 4}، {2، 4}}.
3.2. المعالجة المسبقة للبيانات
بالنسبة لكل من مجموعات بيانات DenseGait وGREW، نستخدم نفس إجراء المعالجة المسبقة. بالنسبة لكل تسلسل هيكلي مستخرج ومتتبع يحتوي على 18 مفصلًا بإحداثيات x وy ودرجة ثقة إضافية، نقوم أولاً بتطبيع التسلسل من خلال التركيز على إحداثيات الحوض (الحوض، الحوض) وعن طريق القياس أفقيًا وعموديًا وفقًا لنسب جسم الإنسان (أي المسافة بين الكتفين: |xR.shoulder − xL.shoulder| والمسافة من الرقبة إلى الحوض: |yneck − ypelvis|). لكل إحداثي (مفصل، مفصل) لكل من المفاصل الـ 18 في تنسيق وضع COCO، نطبق إجراء التسوية التالي:

من خلال عملية التطبيع، يتم التخلص من الاختلافات بين دقة الكاميرا ومسافة الهدف من الكاميرا. علاوة على ذلك، فإننا نحذف معلومات المظهر المتعلقة بارتفاع وعرض الجسم، والتي لا تتعلق بمعلومات الحركة. تشبه هذه الخطوة خطوة المحاذاة في نماذج التعرف على الوجوه الحديثة [42]. علاوة على ذلك، فإننا نستخدم أيضًا طبقة تسوية الدفعة [43] في بداية كل نموذج لزيادة تسوية الصورة الناتجة.
بالنظر إلى البعد الزمني T (أي عدد الإطارات) والبعد المكاني للهيكل العظمي J (أي عدد المفاصل)، يتم تشفير تسلسلات الهيكل العظمي الساذجة كصور ذات شكل (T، J، 3)، حيث، في حالتنا، T {{ 1}} و ي=18.

ومع ذلك، فإن معظم محولات الرؤية تفترض أن الصور مربعة. لذلك، نقترح متغيرات متعددة لتغيير حجم البعد المكاني بحيث يتم تحويل الصورة إلى (T، T، 3)، وهو ما يعادل زيادة عدد المفاصل بشكل مصطنع (انظر الشكل 2).

For more information:1950477648nn@gmail.com